2025 顯卡純硬件規格比較|AI 時代的算力現實
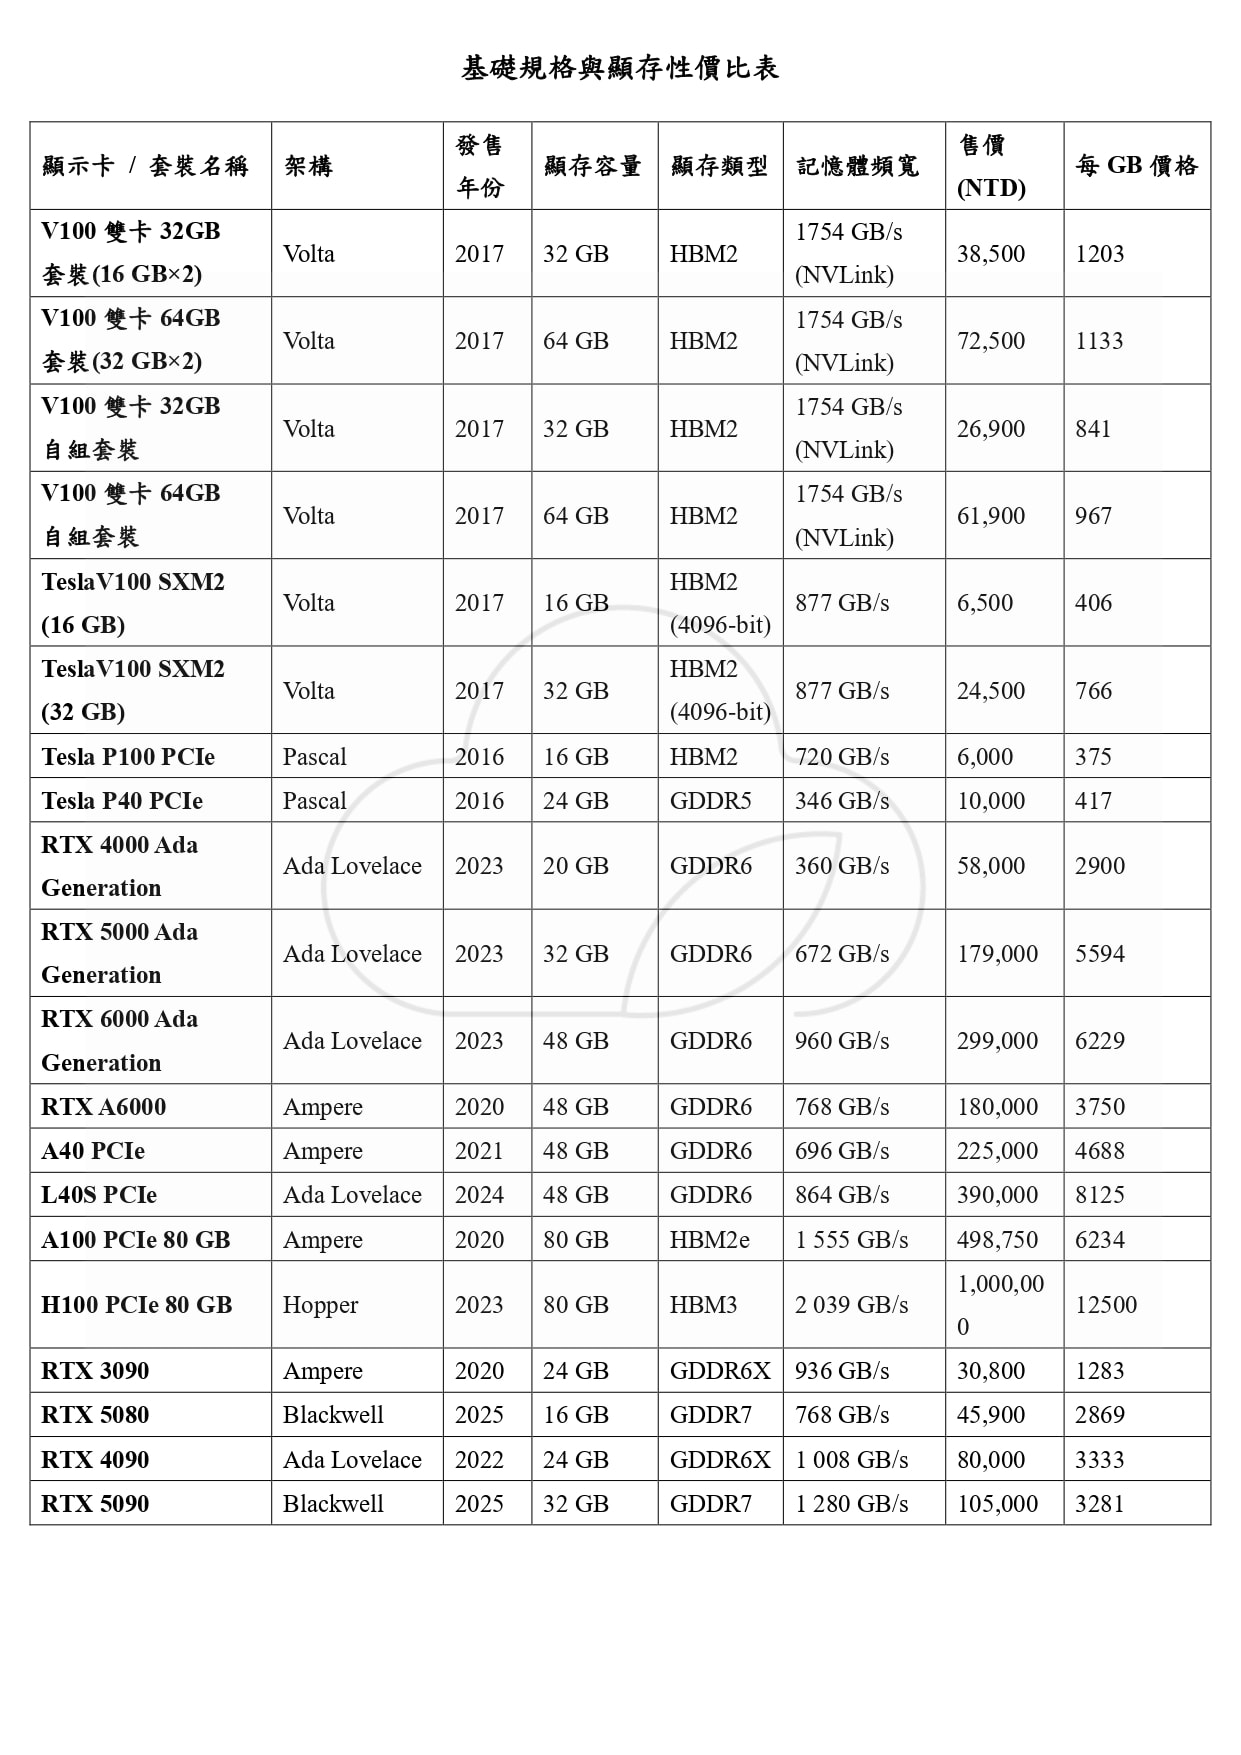
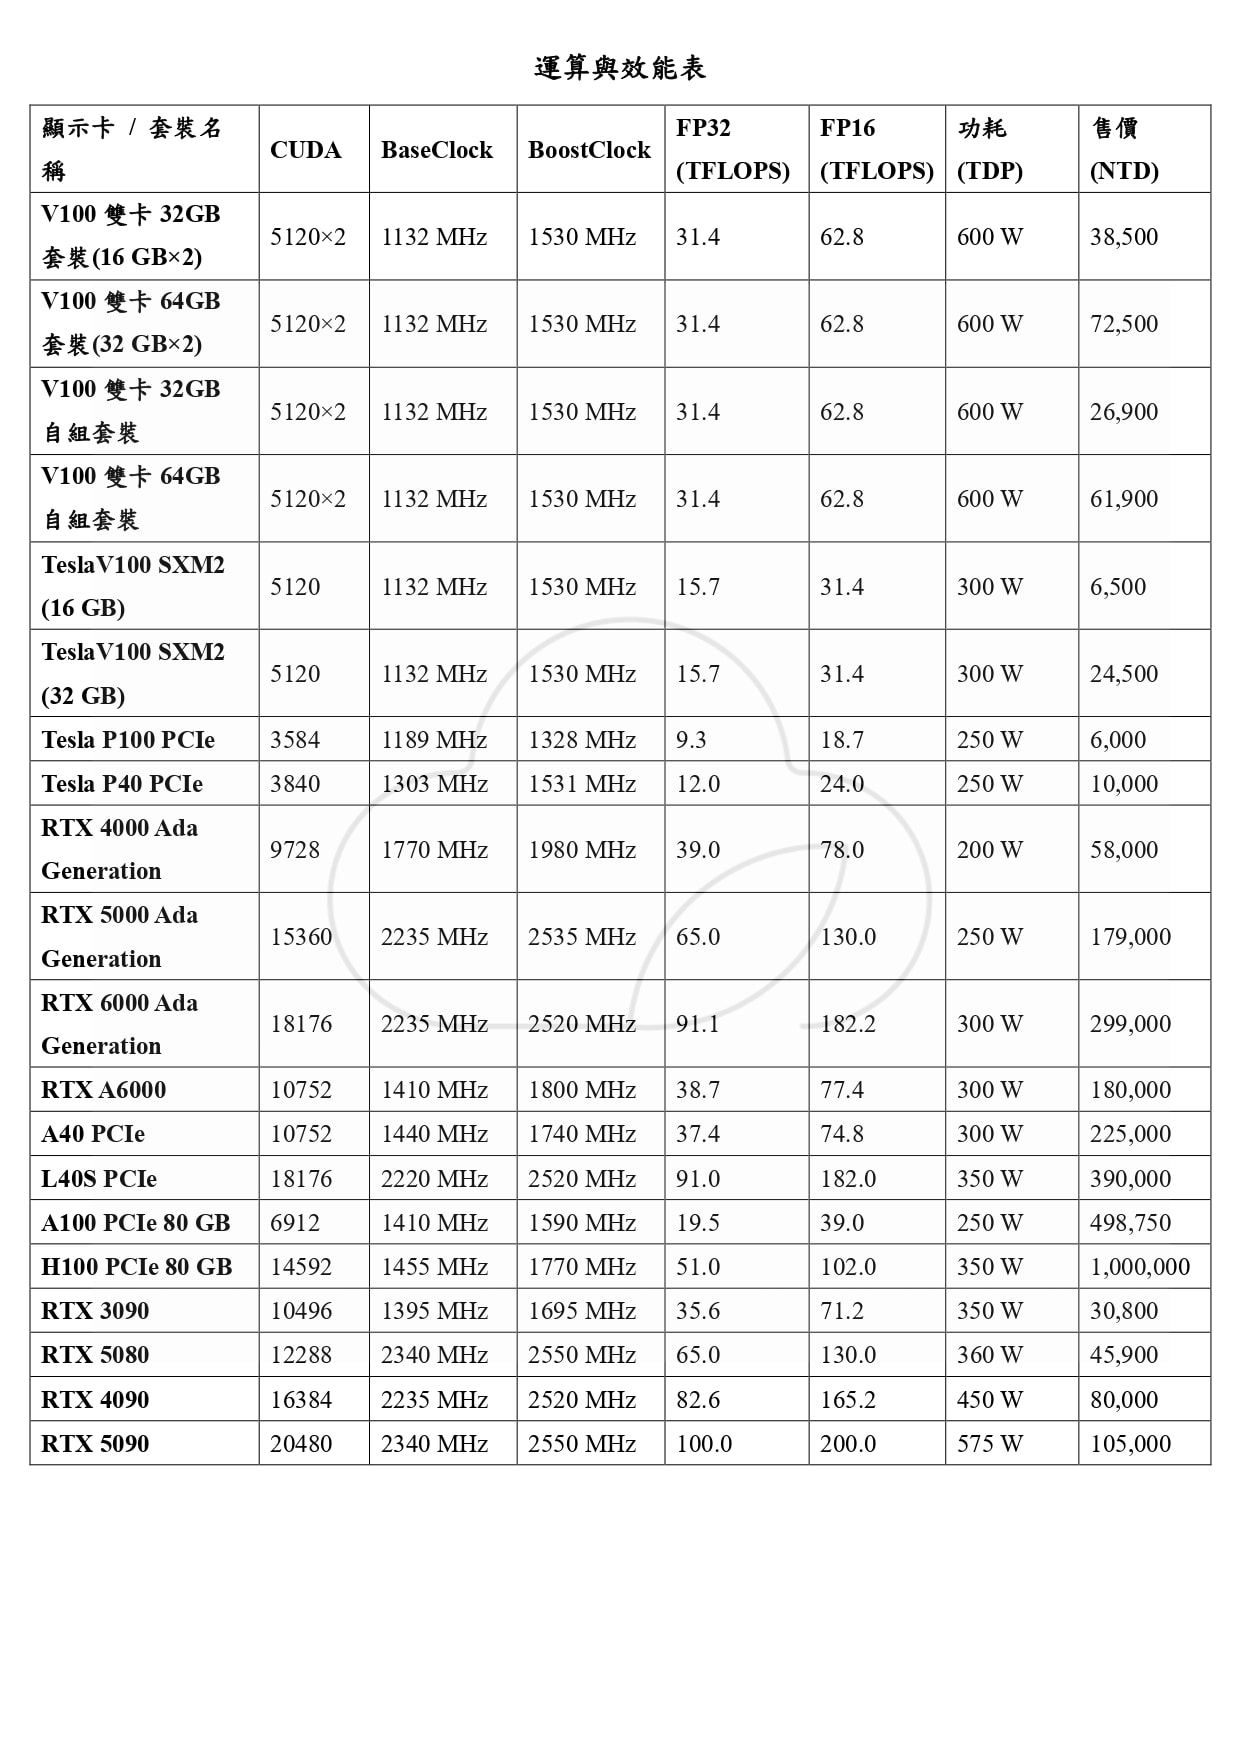
詳細硬件規格比較
AI 模型越趨複雜,真正決定訓練效率與穩定性的,不是品牌或世代,而是架構、顯存與頻寬的平衡。
我們整理了一份完整的 GPU 硬體規格比較,從 Pascal、Volta、Ampere、Ada 到 Hopper、Blackwell 六個架構,系統性分析各代 GPU 在 AI 實務中的效能差異與使用定位。
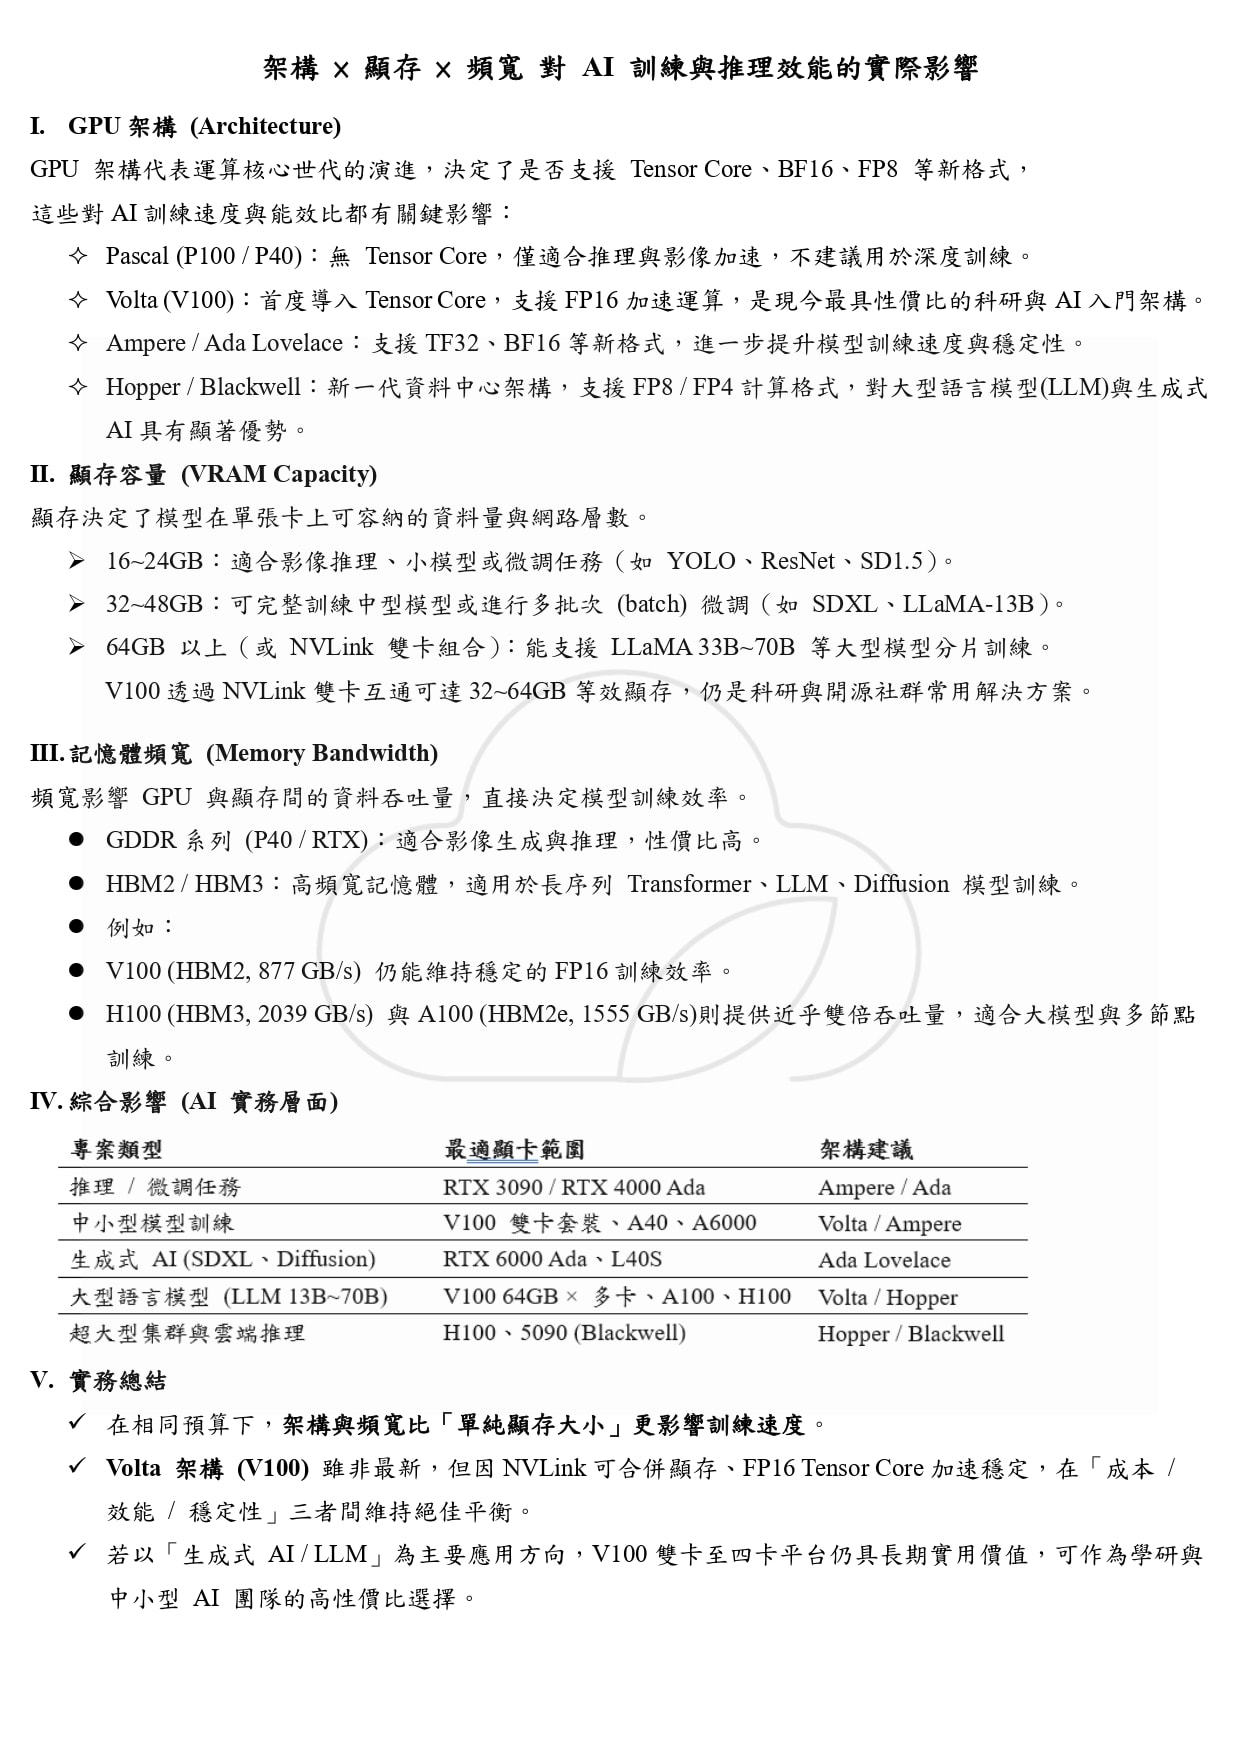
🖥️一、架構 × 顯存 × 頻寬:AI 效能的基礎條件
Pascal (P100 / P40):無 Tensor Core,只適合影像推理或基礎加速。
Volta (V100):首度導入 Tensor Core,FP16 運算效率高,透過 NVLink 雙卡互通可達 32~64GB 等效顯存,是科研與實驗室主流平台。
Ampere / Ada Lovelace:支援 TF32、BF16 格式,訓練速度與精度兼顧。
Hopper / Blackwell:支援 FP8 / FP4,針對 LLM 與生成式 AI 優化。
在實務應用中,架構與頻寬往往比單純的顯存容量更影響訓練速度。
Volta 架構 (V100) 雖非新世代,但在成本、效能、穩定性三者之間仍維持理想平衡。
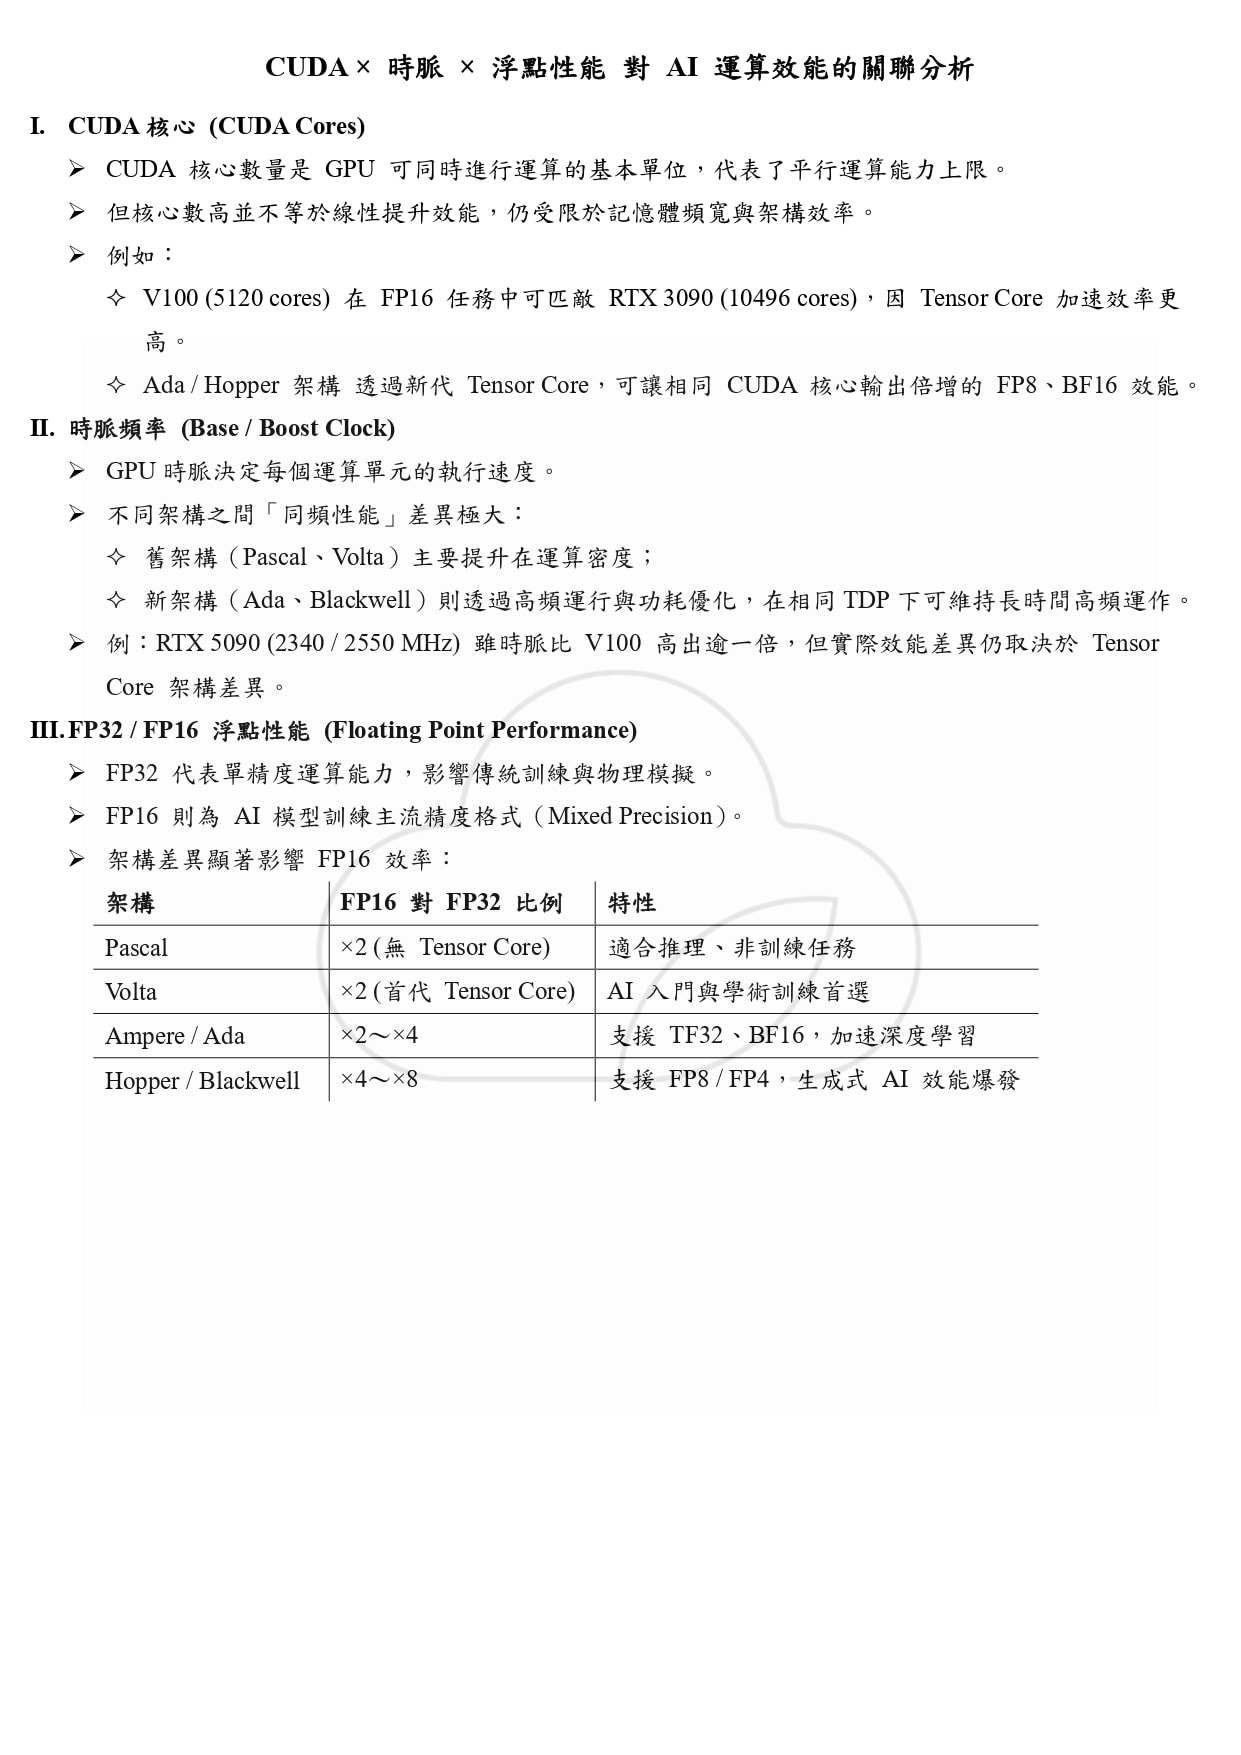
🚀二、CUDA × 時脈 × 精度:決定訓練速度與效率的核心
CUDA 核心與時脈決定理論算力上限,但實際效能仍取決於 Tensor Core 架構與 FP 精度支援。
V100 具備 5120 個 CUDA 核心,雖不及新卡數量,但其 FP16 Tensor Core 效率可與 RTX 3090 相當。
新架構如 Ada 與 Hopper 在 FP8 / BF16 下能輸出更高吞吐量,但在穩定性與溫控方面仍以伺服器卡為優。
V100 採用 HBM2 高頻寬記憶體(877 GB/s),並支援 ECC 檢錯與 NVLink 雙卡互通,長時間運行時頻率穩定、溫度波動小,是民用 RTX 卡難以取代的特性。
📈三、穩定性與長時運行表現
在 AI 訓練環境中,穩定輸出往往比峰值性能更重要。
V100 的 SXM2 架構設計具備資料中心級散熱與電力供應,能在 24 小時以上的訓練任務中保持高效穩定輸出,實測頻率波動小於 ±1.5%,明顯優於消費級 RTX 系列。
NVLink 雙向 300 GB/s 傳輸頻寬讓多卡協同效率更高,即使在長序列 Transformer 或多節點分布式訓練中,仍能保持資料傳輸與梯度同步的穩定性。
💰四、V100 套裝的實務價值
創續科技的 V100 雙卡科研套裝以 SXM2 架構為核心,整合 NVLink 底板、金牌電源與伺服器級散熱,提供科研與 AI 團隊完整的本地運算平台。
在同等預算下,V100 系列以極高的穩定性與可維修性,成為目前最具性價比的 AI 訓練與教學伺服器方案。
📌五、結語
真正的算力不僅取決於 TFLOPS 數字,
而是長期穩定運行、記憶體頻寬與架構效率的綜合表現。
V100 在 FP16 Tensor Core、ECC 穩定性與 NVLink 擴展上仍具實際價值,對於 AI 教學、研究與中小團隊訓練平台而言,它依然是一個成熟、可靠且經濟的選擇。
創續科技有限公司|CXTech Official
LINE:henry911011 0905-153-663